
芯片不再是唯一的悬念。一年前,华为轮值董事长徐直军公布昇腾芯片路线图时,人们关注华为能否做出AI芯片以及何时供货。从950到960、970,未来数年的产品排在一起,对于经历过供应链断裂的公司而言,这张路线图本身就是一种信心。
但当时另一个重要技术——灵衢并未受到同等关注。徐直军表示,去年他提到了互联协议,但大家的关注点都在芯片上,忽略了灵衢的关键作用。
一年后,AI芯片的路线图开始变为现实。昇腾950已经上市,Atlas 950超节点也开始交付,基于它构建的25.6万卡集群正在部署,下一代Atlas 960系统也进入测试阶段。尽管产能依然紧张,随着研发与产品迭代持续推进,外界对华为的期待也在变化。能否做出下一颗芯片仍然重要,但这已不足以解释华为在AI算力上的全部布局。
2026年全联接大会期间,徐直军与华为半导体首席科学家廖恒试图将讨论推进到下一个层级:当芯片数量增加到数千甚至更多时,如何让它们像一台计算机一样工作?大模型训练需要大量处理器频繁交换数据、同步结果,一颗芯片算得再快,也要等其他芯片完成工作。一条链路短暂异常,还可能影响一个运行了很久的任务。因此,买到了多少峰值算力与最终能用上多少有效算力之间存在差距。
大会上,华为发布了Peerium计算架构,通过嵌套并行、统一内存寻址和平等互联,可支撑百万级处理器协作。灵衢是实现这套架构的关键互联技术,全球首个采用NPO技术的超节点——昇腾960超节点正式发布。
华为的发展史就是一部不断连接一切的过程,到了AI时代,连接和计算再次走到一起。去年,徐直军用芯片路线图回答了外界对华为未来的追问;今年,他想解释为什么那些芯片之间的连接同样值得被看见。
过去一年,超节点成为AI产业的热门词汇。但在徐直军看来,不同厂家的超节点有很大区别。主要在于,越来越多的处理器连接起来后,能否高效协同工作。大模型训练需要把任务分给大量处理器,每颗芯片完成自己的计算,还要与其他芯片交换结果,再进入下一阶段。数据不到位,计算就无法继续,一个短板会制约整个系统。
企业购买的芯片越来越多,并不意味着这些等待会自行消失。处理器增加带来的收益,大部分被通信和协议转换的开销抵消。AI仍然需要更快的芯片,也越来越需要能够把这些芯片组织起来的计算架构。廖恒用两组层层嵌套的套娃解释华为的思路:软件把任务分成不同层级的并行工作,硬件也从芯片、板卡、机柜,一直到超节点和更大的集群。Peerium希望让两组结构相互配合,以提高效率。
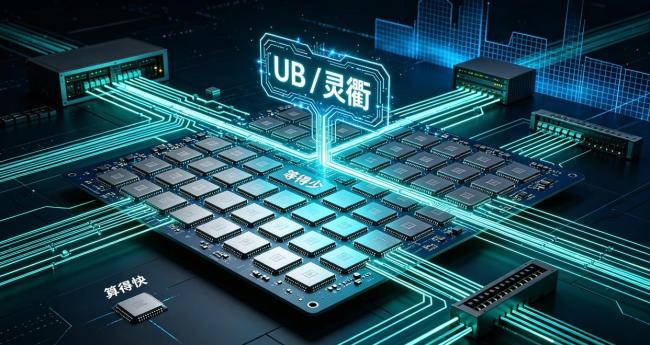
Peerium架构能否立住,关键在于互联。传统上,总线管近处,网络管远处,各有分工。如今,AI把更多处理器拉进同一个任务,也让这条分界线上的代价越来越难以忽略。行业都在寻找解决办法,华为的答案是把更大范围的设备放进同一套互联规则中。
物理距离不会因协议统一而消失,不同位置的带宽和时延仍有差别,但华为希望尽量减小跨越这些边界时的性能损失。灵衢的价值在于它能做到柜间、柜内及数据中心之间都能使用同一协议,还能高速传输。
接下来,华为要让这些能力围绕同一个计算目标重新组织起来。自2020年7月Unified Bus技术项目立项以来,UB经历了技术规范定义、协议版本冻结,进入NPU、CPU和交换芯片的设计与投片阶段,随后还有套片测试和系统验证。灵衢就是这样一步步做出来的。
速率不断提高,传统电连接面临更严苛的距离和信号质量约束。光互联提供了更大的空间,数据转成光信号后,可以在更远的距离上传输。华为选择的NPO(近封装光学)把光引擎放在主芯片附近,保留约五厘米的板上铜连接,其余相关互联转向光连接。NPO保留更长一点的电连接,换来了接近40%的成本下降,以及光引擎相对独立维护的空间。
几颗芯片组成的系统和数万乃至更多芯片组成的系统对故障的感受完全不同。规模足够大时,某个器件失效或某条链路短暂异常都需要纳入正常设计考虑。华为通过检错与重传、替代连接路径及光源冗余等设计,尽量减少底层问题对应用的影响。这提高了系统的稳定性,从而降低了训练成本,加快了训练迭代。
眼下,华为仍在把能力转化为大规模供给的过程中。950PR已经上市,主要面向推理;用于训练的950DT预计今年年底或明年开始规模供货。基于Atlas 950超节点的25.6万卡集群正在部署,基于NPO的Atlas 960系统正在测试。未来,更多模型的训练将构筑在基于950DT的超节点或集群上。
华为希望通过计算产品实现商业回报,而互联只有获得更多参与者才能形成更大的生态。今天的开放也是为未来的产品和市场寻找更广泛的支撑。回看过去几年的经历,华为的计算架构和互联研究在制裁之前已经开始,后来的持续投入才形成了今天的体系。
启盈优配提示:文章来自网络,不代表本站观点。


